CUDA:在没人需要它的年代苦熬十年亏掉百亿市值,把游戏显卡变成算力底座,今天所有大模型都跑在这条护城河上
在过去三年席卷全球的生成式 AI 狂潮中,科技界有一个让无数芯片挑战者感到绝望的现象:
无论是开源社区的开发者、硅谷与中国的顶级大模型实验室,还是云厂商采购经理,哪怕市面上有纸面浮点算力(TFLOPS)更高、价格便宜 40% 的替代加速卡,工程师们的第一反应依然是摇头:“别买那张卡,它的软件栈跑不通,改底层算子要脱一层皮——还是去抢英伟达(NVIDIA)吧。”
把全世界的 AI 工程师死死焊在英伟达战车上的,并不是台积电 4 纳米工艺造出来的硅片,而是一个诞生于整整 20 年前(2006 年) 的并行计算平台与编程模型——CUDA(Compute Unified Device Architecture,统一计算设备架构)。
在全球 改变世界的 100 个产品榜单中,CUDA 位列 第 38 名(综合评分 OVR 89:影响 97 / 开创 95 / 商业 92 / 持久 92 / 规模 82 / 体验 69)。这是商业史上最震撼的一次“十年冷板凳豪赌”:当全世界都把显卡当成给少年们渲染《魔兽世界》和《使命召唤》光影特效的玩具时,CUDA 是如何孤注一掷,把游戏显卡改造成今天四万亿美金帝国的护城河的?
一、2004 年的黑客奇观:为什么斯坦福的博士生在拿「像素着色器」算矩阵?
故事的起点,要追溯到 2003 年前后的斯坦福大学图形学实验室。
当时,以伊恩·巴克(Ian Buck)为首的一群计算机博士生发现了一个有趣的算力剪刀差:
- 一颗顶级的 Intel CPU(中央处理器)就像是**「4 位精通微积分的数学教授」**,擅长处理极其复杂的串行逻辑分支,但一次只能算几道题;
- 而一张用来打 3D 游戏的 GeForce 显卡 GPU(图形处理器),为了在同一毫秒内计算出屏幕上 200 万个像素点的颜色与光影,内部塞满了成百上千个极其简单的算术单元——它就像**「2,000 个会做四则运算的小学生」**,极其擅长同时做大规模矩阵乘法!
为了借用显卡这股恐怖的并行算力来做科学计算,当时的学者们不得不干一件极其痛苦的“黑客苦力活”:他们必须把原本属于流体力学、基因测序或金融期权的数学矩阵伪装成「一张张游戏贴图(Texture)」,再用晦涩难懂的 OpenGL / DirectX 图形着色器语言(Shader)去算光影,最后从渲染出来的像素颜色里把计算结果倒推出来!
黄仁勋敏锐地注意到了这群“不务正业”的极客。2004 年,他亲自把伊恩·巴克招入英伟达,并下达了一个疯狂的任务:“把那些图形学黑话全部拿掉!我们要在 GPU 里面直接修一条让任何懂 C 语言的程序员都能直接调用并行算力的高速公路。”
2006 年 11 月,伴随传奇的 G80 架构(GeForce 8800 GTX),CUDA 1.0 正式面世。程序员历史上第一次不再需要懂什么叫顶点、什么叫纹理贴图,只需要写几行标准的 C 语言扩展(__global__ 核函数),就能瞬间唤醒显卡里成千上万个流处理器(CUDA Cores)并行干活!
二、华尔街骂了整整 6 年的「败家工程」:把成本塞进每一张游戏卡里
今天回看 CUDA,所有人都会觉得黄仁勋是神机妙算的先知;但在 2006 年到 2012 年这整整 6 年时间里,CUDA 差点把黄仁勋逼下台。
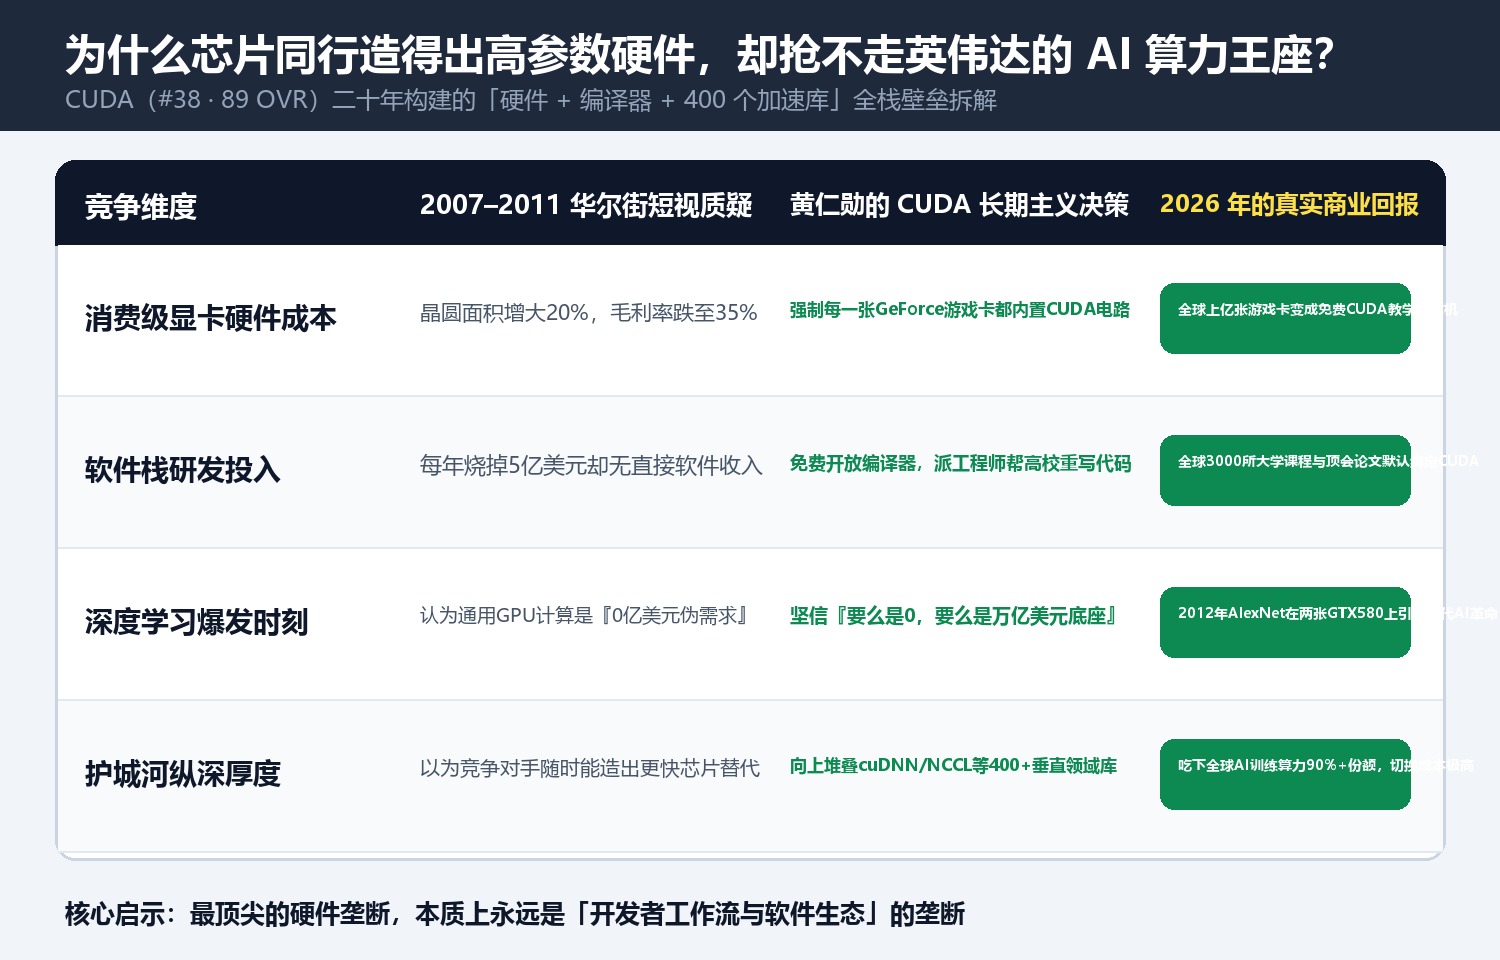
因为黄仁勋做了一个违背所有芯片行业财务常识的决定:他没有把 CUDA 做成只卖给科研机构的昂贵专用卡,而是强制规定——英伟达卖给全球网吧和游戏玩家的每一张消费级 GeForce 显卡,都在硬件晶圆里硬塞进全套 CUDA 计算电路!
这笔账在当年的华尔街分析师眼里简直不可理喻:
| 维度 | 2007–2011 年华尔街的愤怒质疑 | 黄仁勋的「零十亿美元市场」底层逻辑 | 10 年后的真实商业回报 |
|---|---|---|---|
| 芯片硬件成本 | 为了加 CUDA 通用计算单元,每颗芯片晶圆面积暴增 15%~20%,毛利率从 46% 跌到 35% | 如果只有几千张昂贵的科研卡支持 CUDA,全世界根本不会有程序员去学它 | 全球上亿张游戏显卡瞬间变成了免费的 CUDA 教学开发机 |
| 研发烧钱规模 | 每年在 CUDA 编译器、驱动和数学库上烧掉 5 亿美元,却连 1,000 万美元收入都换不回来 | 先用免费硬件铺满全球每一所大学的实验室,让每一篇顶会论文都基于 CUDA 写代码 | 全球 500 万名开发者、3,000 所高校课程全部锁定在 CUDA 生态上 |
| 资本市场代价 | 2008–2012 年英伟达股价暴跌 70%,市值长期在 60 亿美元徘徊,股东大会年年逼宫要求砍掉 CUDA | “如果没人用,我们就自己派工程师去帮气象局、石油公司、医院重写代码!” | 2012 年 AlexNet 在两张 GTX 580 游戏卡上引爆深度学习,英伟达独吞 AI 时代 90% 算力红利 |
在最黑暗的 2009 年,全世界的 CUDA 真实企业客户屈指可数。黄仁勋在年报和股东大会上反复讲他著名的**「零十亿美元市场(Zero-Billion Dollar Market)」理论:“今天通用 GPU 计算的市场规模确实是 0 亿美元;但它要么永远是 0,要么就是未来的万亿美元级底座。”**
三、2012 年的奇迹时刻与「400 个加速库」筑起的铁壁
转折点在 2012 年 9 月 30 日 轰然降临。
多伦多大学的杰弗里·辛顿(Geoffrey Hinton)与他的两名学生伊利亚·苏茨克维(Ilya Sutskever,后来 OpenAI 联合创始人兼首席科学家)、亚历克斯·克里泽夫斯基(Alex Krizhevsky),在卧室里用 两张买来打游戏的 NVIDIA GTX 580 显卡(单张仅售 500 美元),用 CUDA 手写了深度卷积神经网络 AlexNet,在 ImageNet 视觉识别大赛上以碾压第二名 10 个百分点的成绩震惊全球!
为什么 AlexNet 会诞生在两张游戏显卡上?就因为黄仁勋在过去 6 年里不计成本地把 CUDA 塞进了每一张普通游戏卡里,让一个买不起昂贵超算的博士生,在宿舍卧室里就能直接调用数千个并行核心训练神经网络!
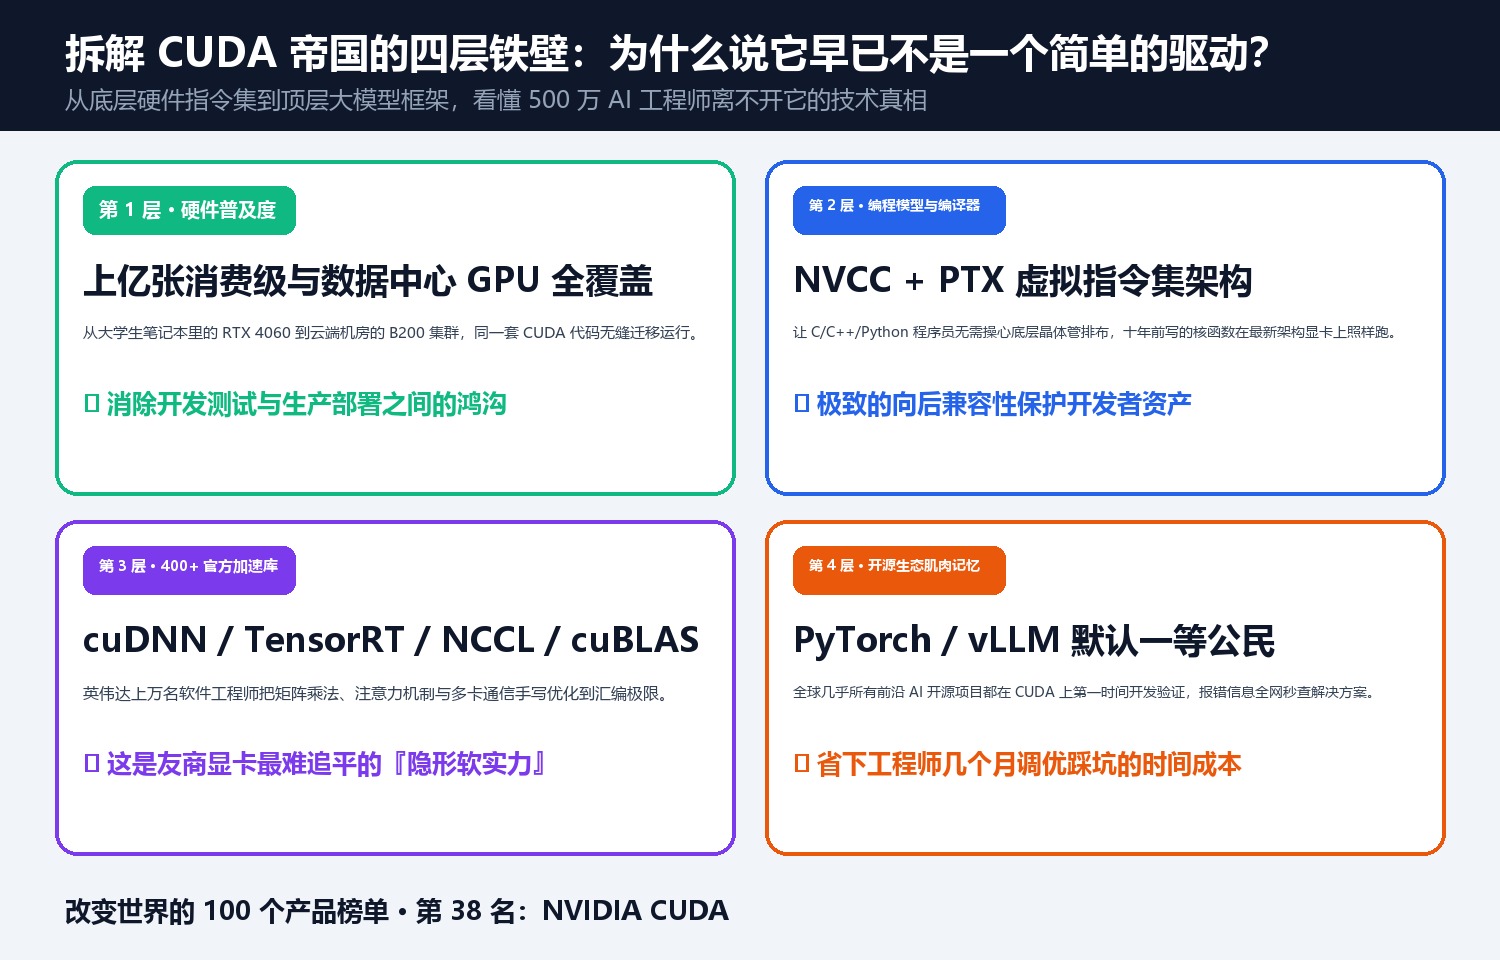
而在 2012 年之后,CUDA 真正让人绝望的第二道护城河才彻底展开——它早已不是一个简单的编译器,而是演化成了覆盖所有垂直领域的**「400+ 官方算子加速库帝国」**:
- 做深度学习训练?有手写到汇编级极限优化的 cuDNN;
- 做大模型张量并行与跨机通信?有 NCCL 与 TensorRT-LLM;
- 做线性代数、傅里叶变换、流体仿真、基因测序、机器人物理引擎?有 cuBLAS、cuFFT、Parabricks、Isaac。
这就是为什么 CUDA 在产品榜上的「体验分」只有 69 分(C++ 底层显存管理、线程块调度与 PTX 汇编对新手极其陡峭),但「影响分(97)」和「开创分(95)」却接近满分: 芯片同行花两年时间可以仿制出一颗晶圆,但要重写过去 20 年里英伟达上万名软件工程师一行行调优出来的 400 个底层库、以及全球 500 万开发者围绕 CUDA 写下的数亿行开源代码,无异于徒手搬走整座喜马拉雅山。
四、CUDA 给产品人的终极启示:最硬的硬件公司,本质上都是软件生态公司
回望 CUDA 二十年的封神之路,它留下了三条足以写进教科书的产品铁律:
- 真正的垄断壁垒,永远建在「开发者工作流与切换成本」上:硬件参数每一代都会被重新洗牌,但一旦全世界所有教材、所有开源框架(PyTorch / TensorFlow)的默认第一行代码都跑在你的软件栈上,你就拥有了印钞权。
- 用存量现金牛硬件,去免费补贴未来的生态底座:如果没有把 CUDA 免费预装进上亿张 GeForce 游戏显卡的魄力,CUDA 早在 2010 年就死在了冷门科研机房里。
- 伟大的长期主义,是敢在「0 亿美元市场」里孤独地修十年路。
讨论