TAG · 标签

# 大模型

← 全部标签 · 共 4 篇

2026-09-23

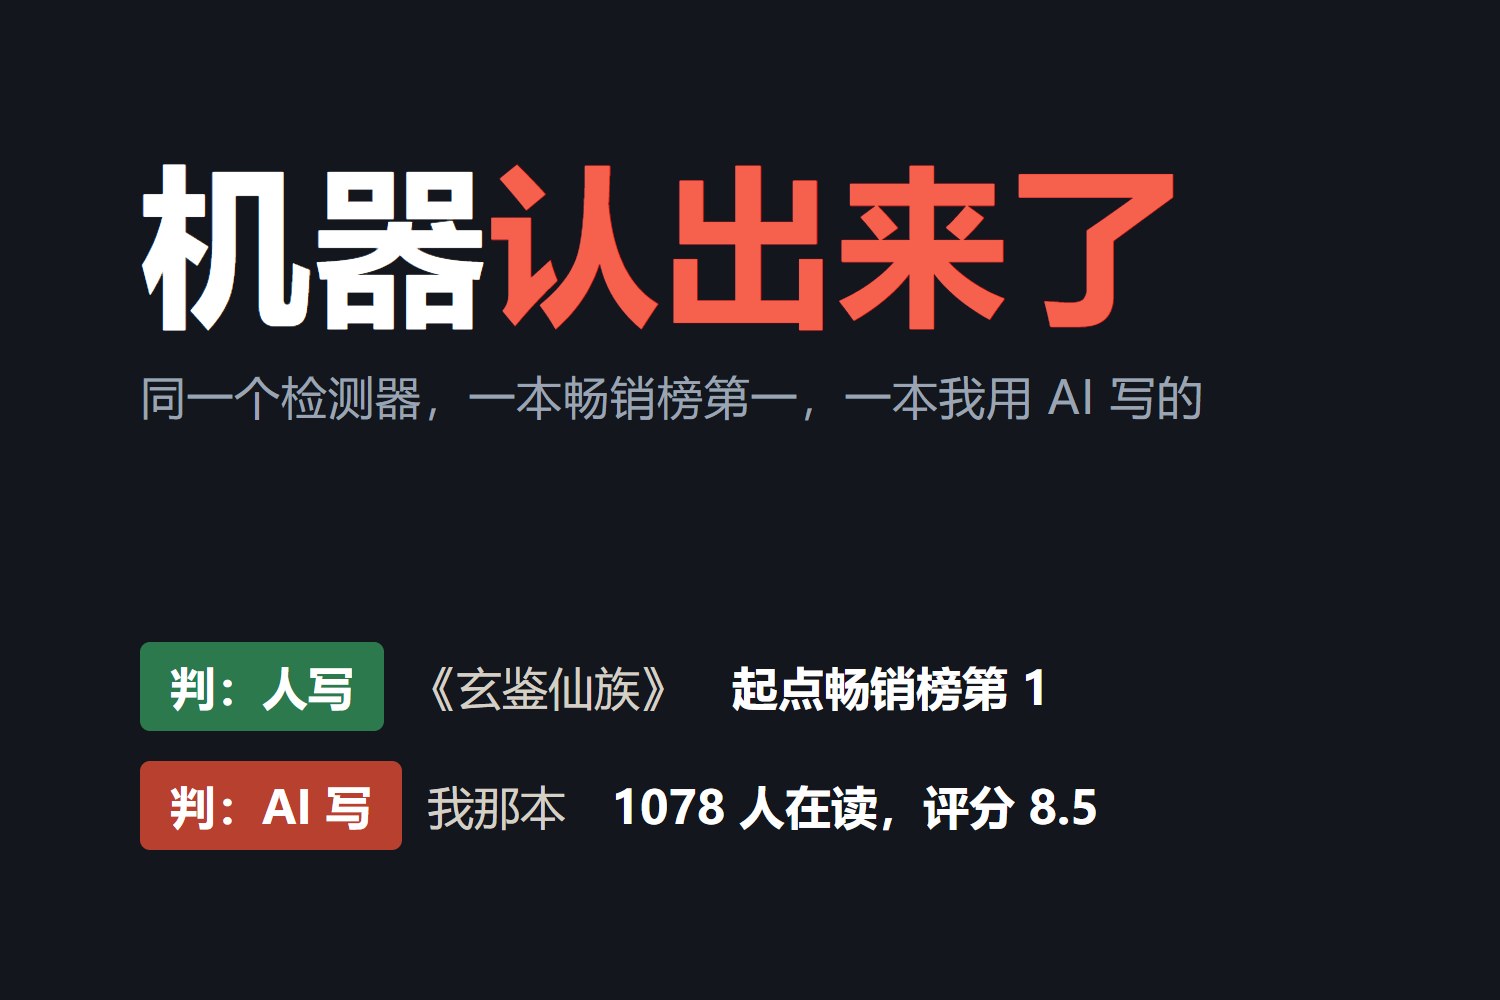
我把畅销榜第一和自己的 AI 小说一起喂给了检测器

腾讯朱雀看《玄鉴仙族》第七十章的 1200 字,给的词是「人工创作特征显著」;看我账号上在读 1078 人、评分 8.5 的那本,给的是「未发现明显的人工创作特征」。那本是 AI 写的。四段样本朱雀方向全判对。换成 ZeroGPT,它把起点畅销榜第一也判成了 AI,百分比还显示 0%。

我把畅销榜第一和自己的 AI 小说一起喂给了检测器
2026-09-22

判断大模型有没有意识,我的标准是能不能自主写完一本小说

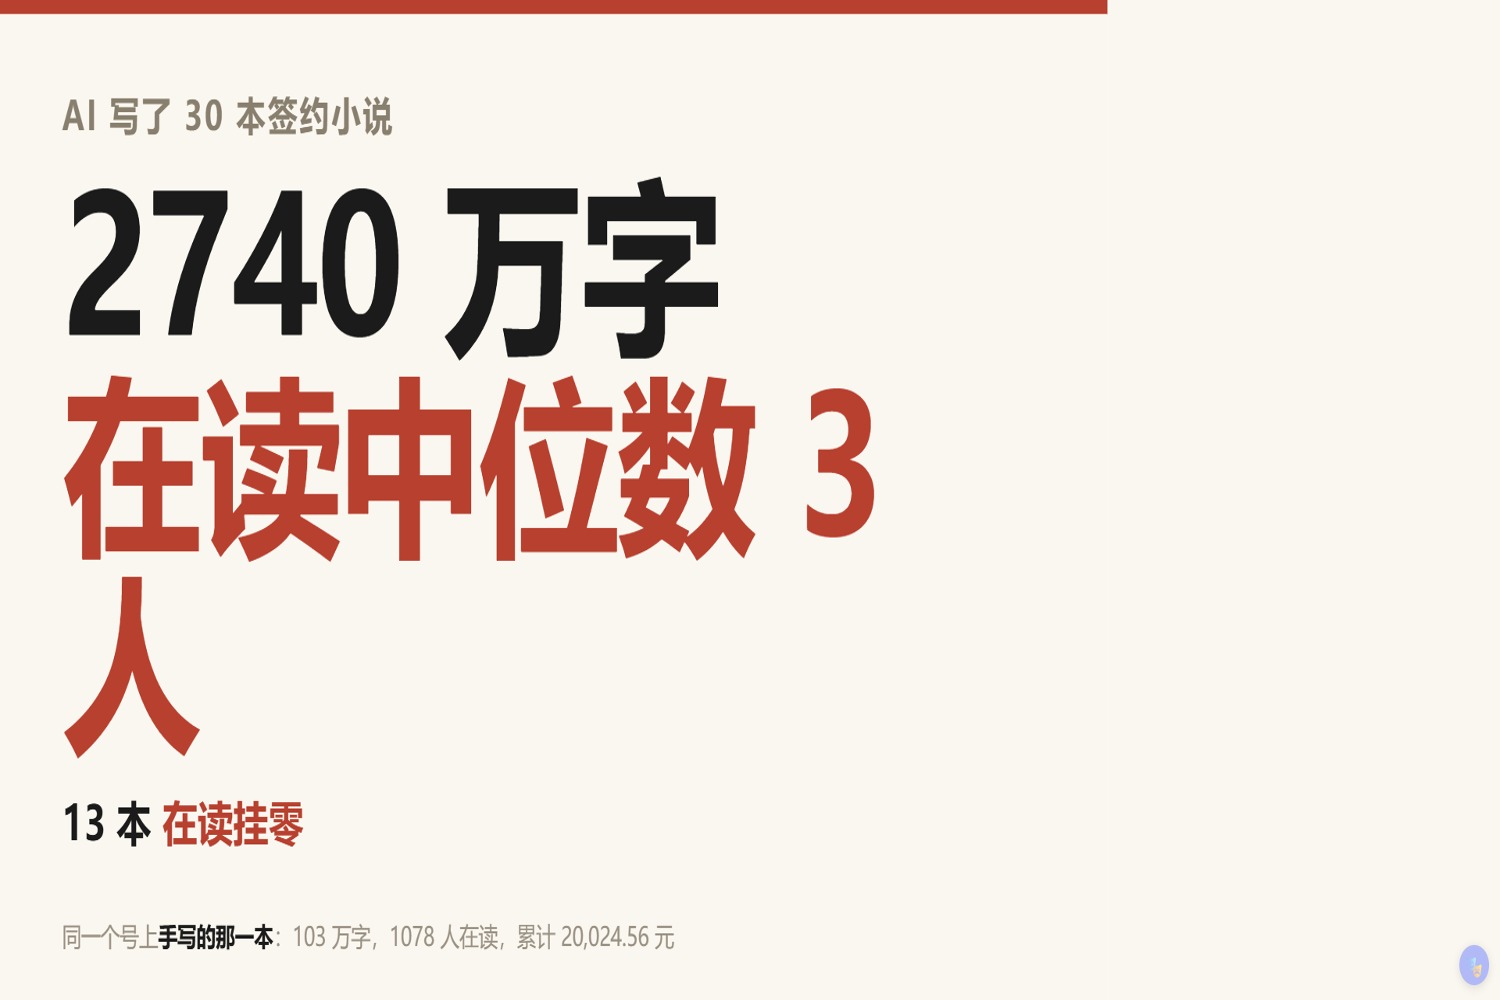
图灵测试早就被通过了,跑分也一项项刷满了,但没人真的因此认为模型有意识。我提一个新判据:让它自主写完一本长篇小说——不是写出一百万字,是写出一本有人愿意读完的书。这件事需要的东西,恰好是所有 benchmark 都测不到的:跨越几个月维持一个意图、猜别人什么时候想放下手机、在第两百章发现前面写塌了要回头处理。我用六个顶级模型写了 30 本,2740 万字,在读人数中位数是 3。

判断大模型有没有意识,我的标准是能不能自主写完一本小说
2026-09-21

我用AI写了30本小说2740万字,在读人数中位数是3

六个顶级模型都用过,自己写了编排工具,产出 30 本签约作品、2740 万字。番茄后台的真实数据:在读人数合计 1400,中位数 3 人,13 本挂零。而同一个账号上另一本同样是 AI 写、但我每章盯着留存改的,103 万字,在读 1078 人,累计收益 20024.56 元。更扎心的是——我自己认为模型写得最好的那本,只有 18 个人在读。

我用AI写了30本小说2740万字,在读人数中位数是3
2026-07-18

又一次 DeepSeek 时刻:2.8 万亿的 Kimi K3 屠榜,中国开源模型在编程上反超了 GPT 和 Claude——还全部免费

7 月 16 号月之暗面甩出 Kimi K3,几个小时后马斯克在测评推文底下就俩字:Impressive;《财富》杂志说市场反应「像极了当年的 DeepSeek 恐慌」。这一次比 DeepSeek 还狠——DeepSeek 靠的是便宜到吓人,Kimi K3 靠的是强到反超、还全部免费。在 FrontierSWE、SWE Marathon、前端代码竞技场这些最难注水的编程和 agent 硬榜上,一个你能整个搬回家的中国开源模型,把 GPT-5.6 Sol 和 Claude 的最强闭源旗舰摁在了身下。2.8 万亿参数、全球最大开源模型、7 月 27 号权重全部白送,定价却敢跟 Claude 叫齐。这篇把最硬的数字一个个砸给你看,也说清楚它对每天用 AI 造东西的人意味着什么。
又一次 DeepSeek 时刻:2.8 万亿的 Kimi K3 屠榜,中国开源模型在编程上反超了 GPT 和 Claude——还全部免费